Епоха панування хмарних нейромереж зіштовхується зі зростаючим прагненням до приватності та автономності. Локальний запуск великих мовних моделей трансформується з технічного курйозу на практичну необхідність для багатьох спеціалістів. Проте прірва між вимогами сучасних LLM та можливостями споживчого заліза залишається критичною. Аналіз можливостей сімейства Qwen3.8 дозволяє визначити реальний поріг ефективності домашніх систем та оцінити потенціал методів дистиляції знань.
Питання доцільності розгортання локального штучного інтелекту за наявності доступу до потужних хмарних сервісів давно перестало бути суто технічним. Йдеться про баланс між комфортом і контролем: приватність даних, відсутність цензури та незалежність від зовнішніх API стають вагомими аргументами на користь власного «заліза». У центрі уваги сучасної спільноти open-weight моделей опинилося сімейство Qwen3.8 від Alibaba Cloud. Назва серії, що в оригіналі означає «пошук істини через тисячу запитань», іронічно перегукується з латинським «question», створюючи свого роду інтелектуальний каламбур.
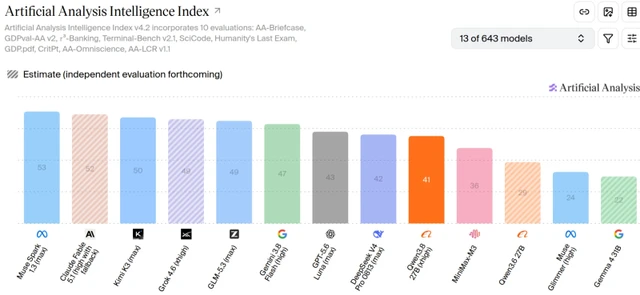
Технічний ландшафт Qwen3.8 вражає своєю різноманітністю. Від флагманської закритої моделі Qwen3.8-Max із 2,4 трлн параметрів до доступних версій із відкритими вагами, таких як Qwen3.8-27B. Остання, попри значний обсяг параметрів, здатна конкурувати з пропрієтарними гігантами на кшталт GPT-5.6 Luna в незалежних бенчмарках. Однак для запуску такої моделі на споживчому обладнанні — наприклад, на системі з відеокартою GeForce GTX 1070 та 8 ГБ VRAM — потрібні радикальні заходи з оптимізації.
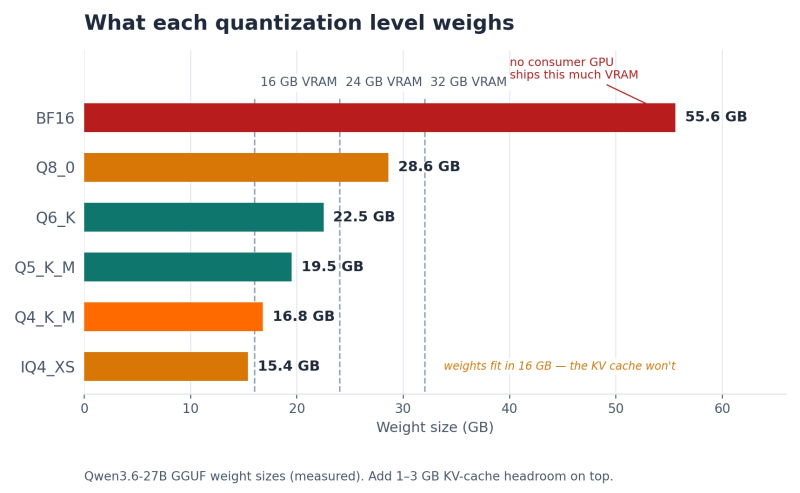
Ключовим інструментом тут стає квантизація — процес зниження точності ваг моделі для зменшення її обсягу. Використання середовища Unsloth Desktop та формату GGUF дозволяє застосовувати динамічну квантизацію IQ, яка спирається на матрицю важливості (imatrix). Це дозволяє вибірково зберігати точність критично важливих шарів нейромережі, стискаючи інші. У результаті модель, яка в початковому 16-бітному представленні не помістилася б навіть у 32 ГБ відеопам'яті, може працювати у стиснутому вигляді, зберігаючи при цьому здатність до складних міркувань.
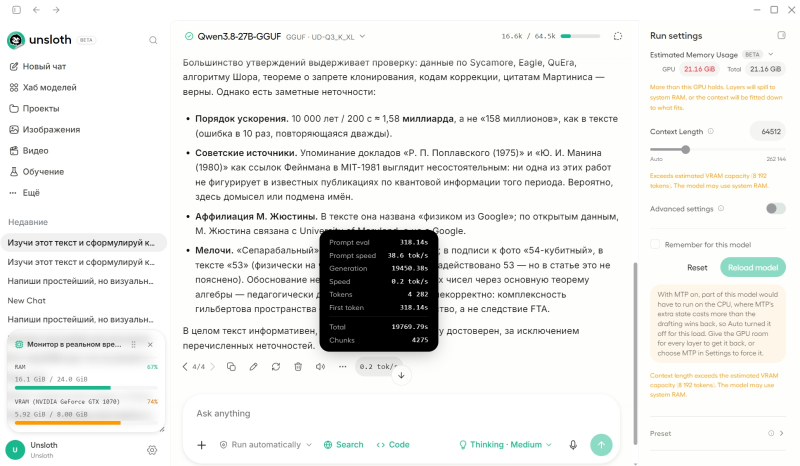
Проте реальність «домашнього» інференсу сувора. При використанні глибоко квантованої версії Qwen3.8-27B (наприклад, UD-IQ1_S) швидкість генерації може впасти до критичних 0,2–0,4 токена за секунду. Основна проблема полягає в переповненні відеопам'яті: щойно контекстне вікно «випліскується» зі швидкої VRAM у повільну системну RAM, продуктивність обвалюється. Більше того, глибокі здібності моделі до міркування (reasoning) іноді стають її пасткою.
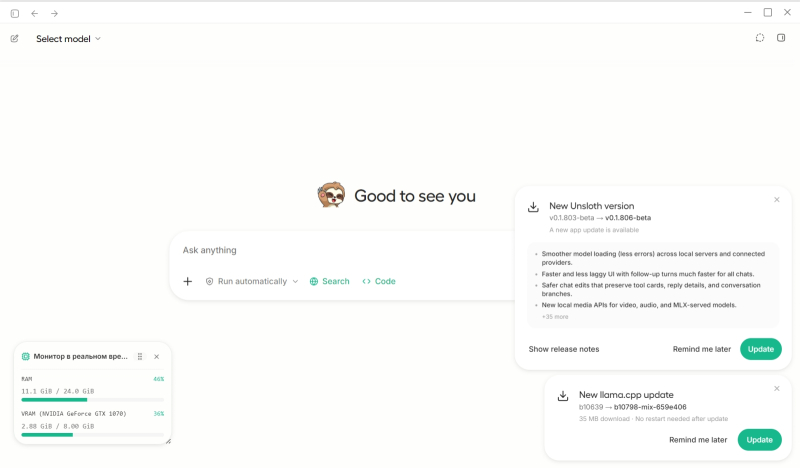
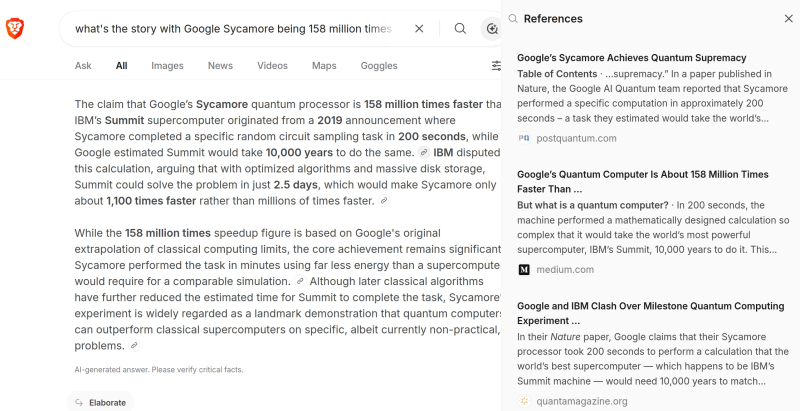
Практичні тести демонструють небезпечний феномен «логічного зациклення». При спробі проаналізувати складний текст про квантову перевагу, модель Qwen3.8-27B у низькій якості квантизації потрапила в нескінченний цикл перевірки математичних розрахунків. Намагаючись зіставити дані про швидкість обчислень процесора Sycamore та суперкомп'ютера Summit, нейромережа витратила кілька годин на внутрішні міркування, що зрештою призвело до вичерпання всієї доступної оперативної пам'яті та краху системи. Цей випадок наочно ілюструє ризик використання занадто «розумних» моделей на слабкому залізі: прагнення до ідеальної точності може паралізувати роботу.
Виходом із цього глухого кута стає дистиляція знань. Модель Qwen3.8-9B-Distill є результатом навчання меншої моделі (Qwen 3.5-9B) на основі «траєкторій міркувань» більшого «вчителя» (Qwen3.8-2.4T-A95B). Метод контрольованого налаштування (SFT) дозволяє передати молодшій моделі не просто правильні відповіді, а саму логіку прийняття рішень. Результати виявилися вражаючими: Qwen3.8-9B не лише працює значно швидше, а й демонструє гнучкіший підхід до вирішення завдань. Там, де старша модель зациклилася на цифрах, дистильована версія змогла обійти «мертву петлю», оцінивши контекст проблеми та видавши коректний результат за лічені секунди.
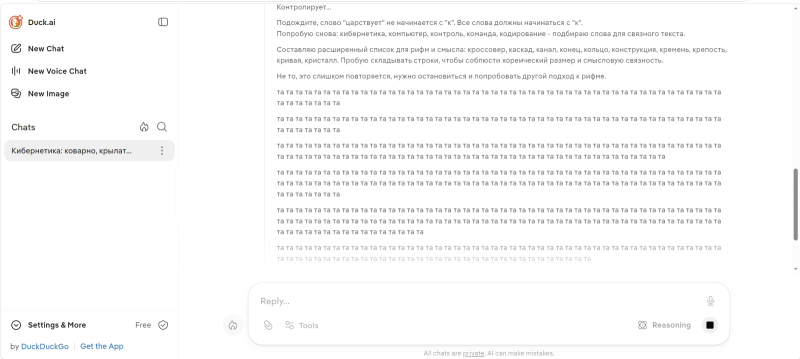
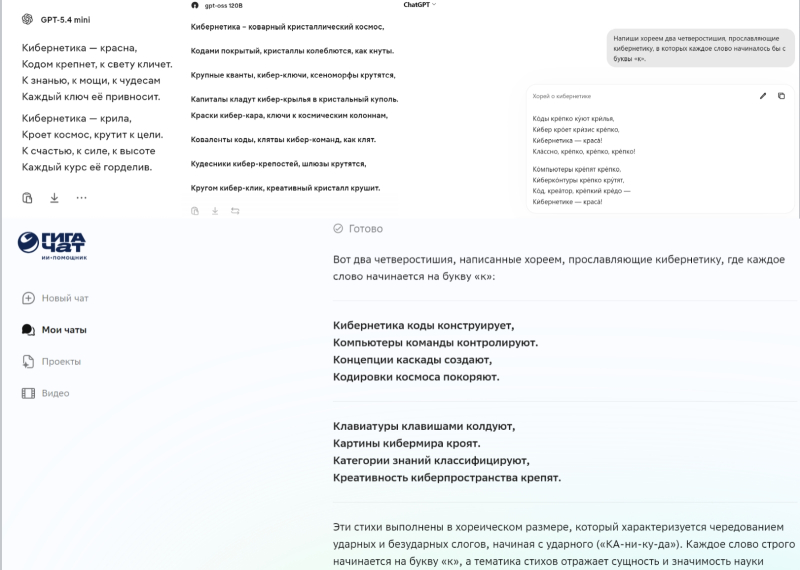
Здібності локальних моделей до творчості та аналізу неоднорідні. В епістолярному жанрі Qwen3.8-9B проявляє себе як майстерний імітатор бюрократичного стилю, легко створюючи абсурдні, але структурно бездоганні службові записки. Однак у галузі суворої поезії — наприклад, при спробі написати хорей, де всі слова починаються на одну літеру — навіть найпросунутіші локальні моделі пасують, западаючи в «плаский штопор» із повторюваних токенів. Тут перевага залишається за важковаговими хмарними системами на кшталт GPT-6 Astra, які мають достатній обсяг параметрів для керування складними лінгвістичними обмеженнями.
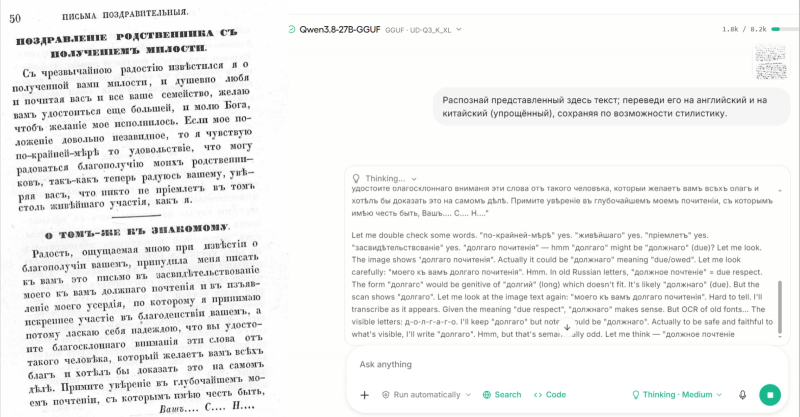
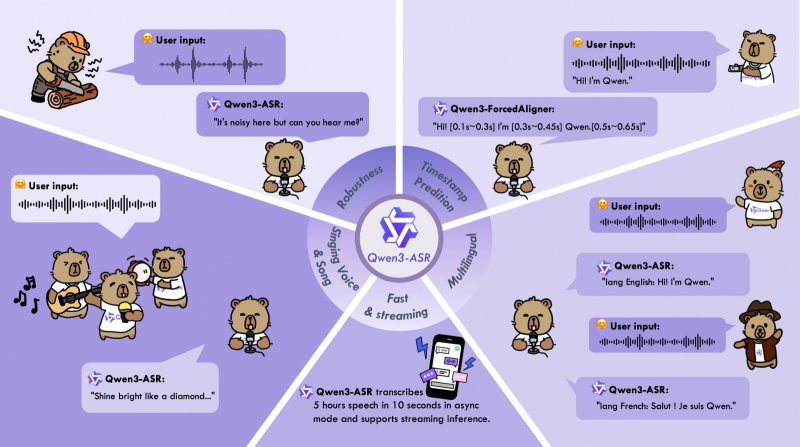
Попри обмеження, мультимодальні можливості Qwen3.8-27B відкривають цікаві перспективи. Модель здатна розпізнавати тексти з дореволюційною орфографією та перекладати їх сучасними мовами, що робить її корисним інструментом для роботи з архівами. Також вона ефективно справляється з аналізом візуальних мемів, розрізняючи технічну помилку та комічний ефект. Для тих же, кому потрібна робота з аудіо, існують спеціалізовані гілки Qwen-Audio (наприклад, Qwen3-ASR), які дозволяють транскрибувати мовлення локально, забезпечуючи повну конфіденційність розмов.
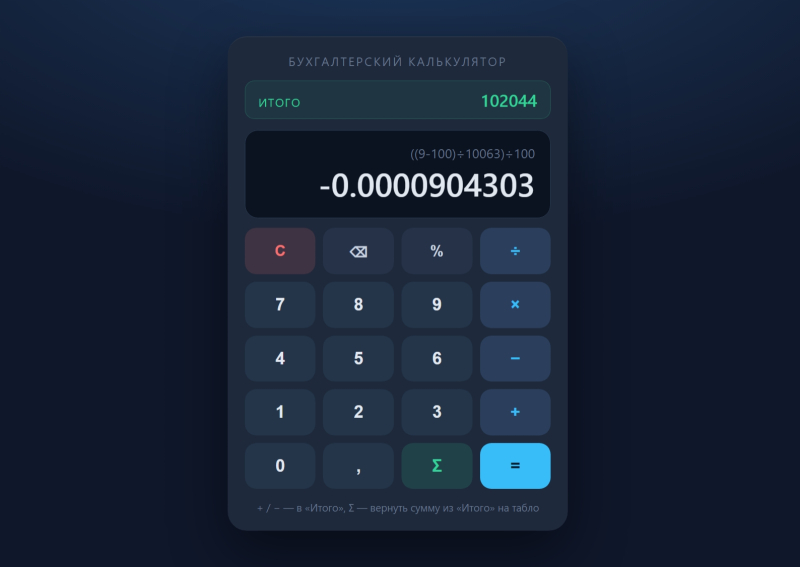
Завершальним випробуванням стало написання програмного коду. Створення навіть простого бухгалтерського калькулятора виявилося серйозним викликом. Якщо мала модель 9B часто помилялася і зависала, то Qwen3.8-27B, попри свою повільність, змогла створити працездатний продукт. Процес зайняв близько шести годин, але результат підтвердив тезу: для складних інженерних завдань глибина міркувань важливіша за швидкість.
Досвід роботи з сімейством Qwen показує, що локальний ШІ перестав бути іграшкою для ентузіастів. Хоча хмарні гіганти все ще лідирують у швидкості та поетиці, дистильовані моделі роблять високорівневий інтелект доступним навіть на застарілому обладнанні. Вибір між швидкістю та глибиною міркувань тепер лежить на користувачеві, який сам визначає, де йому важливіша ефективність, а де — абсолютна приватність та автономність мислення машини.
 Прогноз багатократного зростання поставок Nvidia