Эпоха доминирования облачных нейросетей сталкивается с растущим запросом на приватность и автономность. Локальный запуск больших языковых моделей превращается из технического курьеза в практическую необходимость для многих специалистов. Однако разрыв между требованиями современных БЯМ и возможностями потребительского железа остается критическим. Исследование возможностей семейства Qwen3.8 позволяет определить реальный порог эффективности домашних систем и оценить потенциал методов дистилляции знаний.
Вопрос о целесообразности развертывания локального искусственного интеллекта при наличии доступа к мощным облачным сервисам давно перестал быть чисто техническим. Речь идет о балансе между комфортом и контролем: приватность данных, отсутствие цензуры и независимость от внешних API становятся весомыми аргументами в пользу собственного «железа». В центре внимания современного сообщества open-weight моделей оказалось семейство Qwen3.8 от Alibaba Cloud. Название серии, которое в оригинале означает «поиск истины через тысячу вопрошаний», иронично перекликается с латинским «question», создавая своего рода интеллектуальный каламбур.
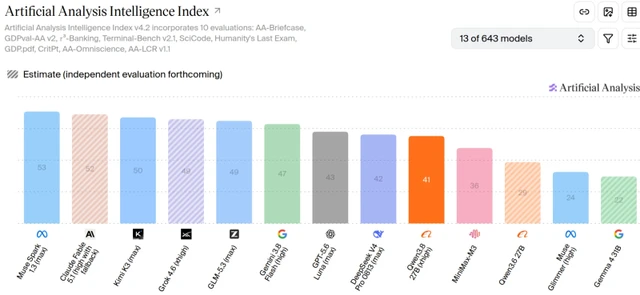
Технический ландшафт Qwen3.8 впечатляет своим разнообразием. От флагманской закрытой модели Qwen3.8-Max с 2,4 трлн параметров до доступных версий с открытыми весами, таких как Qwen3.8-27B. Последняя, несмотря на внушительный объем параметров, способна конкурировать с проприетарными гигантами вроде GPT-5.6 Luna в независимых бенчмарках. Однако для запуска такой модели на потребительском оборудовании — например, на системе с видеокартой GeForce GTX 1070 и 8 ГБ VRAM — требуются радикальные меры по оптимизации.
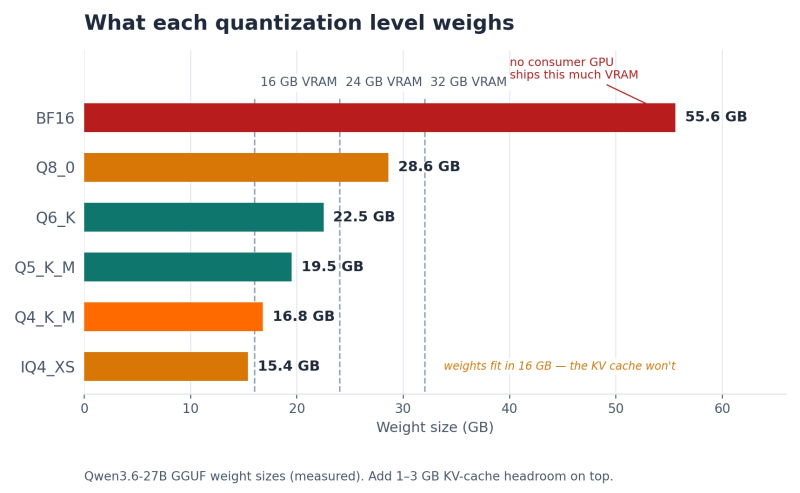
Ключевым инструментом здесь становится квантизация — процесс снижения точности весов модели для уменьшения её объема. Использование среды Unsloth Desktop и формата GGUF позволяет применять динамическую квантизацию IQ, которая опирается на матрицу важности (imatrix). Это позволяет выборочно сохранять точность критически важных слоев нейросети, сжимая остальные. В результате модель, которая в исходном 16-битном представлении не поместилась бы даже в 32 ГБ видеопамяти, может работать в сжатом виде, сохраняя при этом способность к сложному рассуждению.
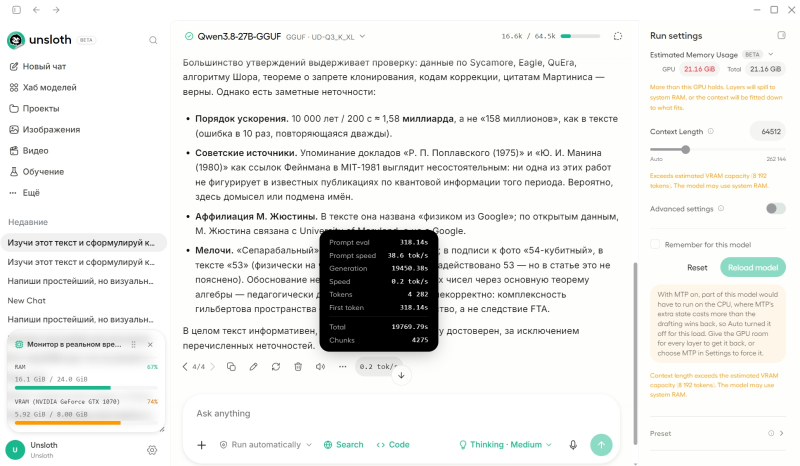
Тем не менее, реальность «домашнего» инференса сурова. При использовании глубоко квантованной версии Qwen3.8-27B (например, UD-IQ1_S) скорость генерации может упасть до критических 0,2–0,4 токена в секунду. Основная проблема заключается в переполнении видеопамяти: как только контекстное окно «выплескивается» из быстрой VRAM в медленную системную RAM, производительность обваливается. Более того, глубокие способности модели к рассуждению (reasoning) иногда становятся её ловушкой.
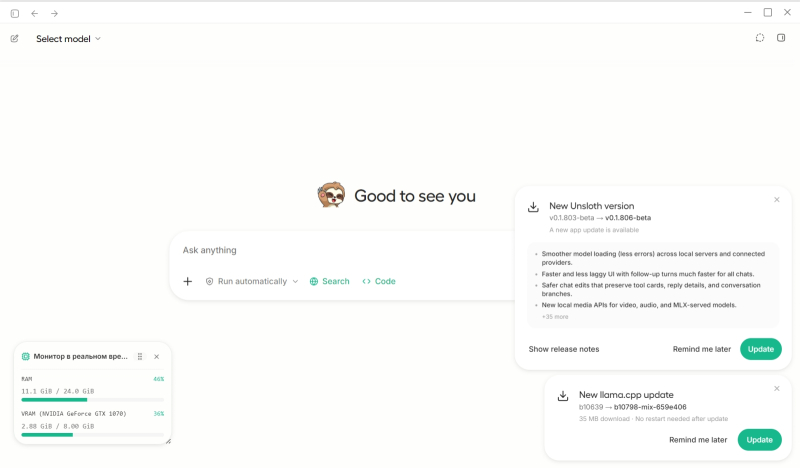
Практические тесты демонстрируют опасный феномен «логического зацикливания». При попытке проанализировать сложный текст о квантовом превосходстве, модель Qwen3.8-27B в низком качестве квантизации попала в бесконечный цикл перепроверки математических расчетов. Пытаясь сопоставить данные о скорости вычислений процессора Sycamore и суперкомпьютера Summit, нейросеть потратила несколько часов на внутренние рассуждения, что в итоге привело к исчерпанию всей доступной оперативной памяти и краху системы. Этот случай наглядно иллюстрирует риск использования слишком «умных» моделей на слабом железе: стремление к идеальной точности может парализовать работу.
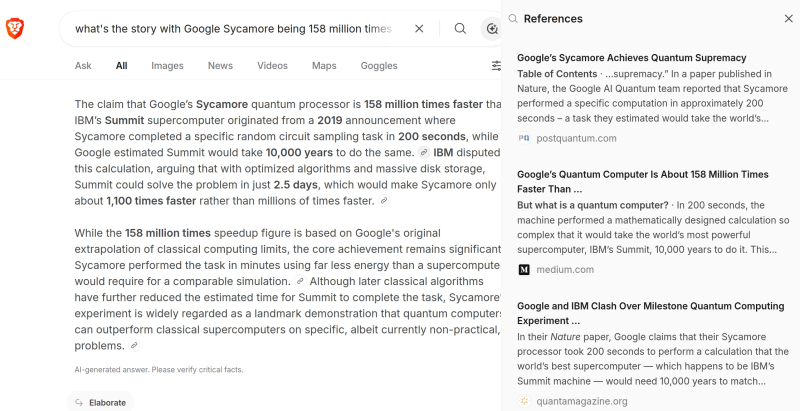
Выходом из этого тупика становится дистилляция знаний. Модель Qwen3.8-9B-Distill представляет собой результат обучения меньшей модели (Qwen 3.5-9B) на основе «трасс рассуждений» более крупного «учителя» (Qwen3.8-2.4T-A95B). Метод контролируемой юстировки (SFT) позволяет передать младшей модели не просто правильные ответы, а саму логику принятия решений. Результаты оказались поразительными: Qwen3.8-9B не только работает значительно быстрее, но и демонстрирует более гибкий подход к решению задач. Там, где старшая модель зациклилась на цифрах, дистиллированная версия сумела обойти «мертвую петлю», оценив контекст проблемы и выдав корректный результат за считанные секунды.
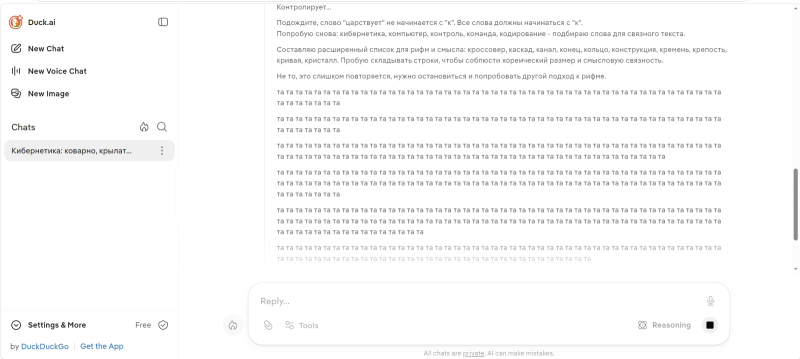
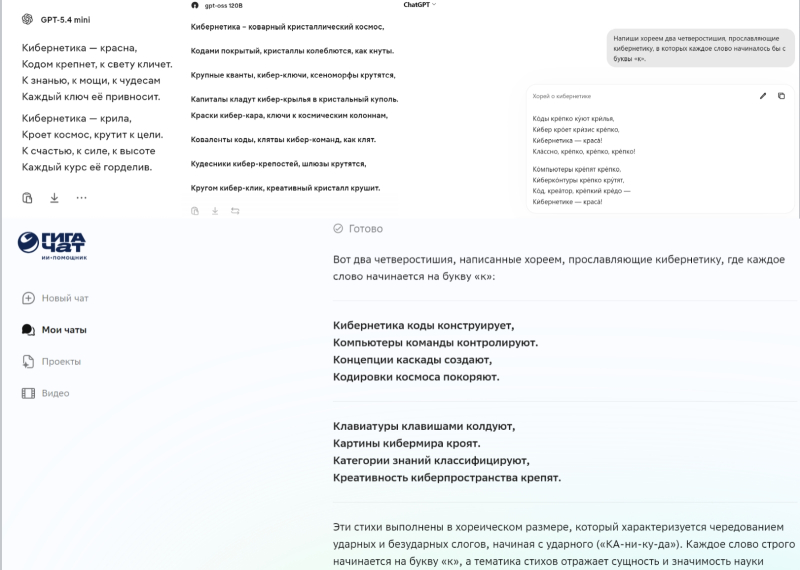
Способности локальных моделей к творчеству и анализу неоднородны. В эпистолярном жанре Qwen3.8-9B проявляет себя как искусный имитатор бюрократического стиля, легко создавая абсурдные, но структурно безупречные служебные записки. Однако в области строгой поэзии — например, при попытке написать хорей, где все слова начинаются на одну букву — даже самые продвинутые локальные модели пасуют, сваливаясь в «плоский штопор» из повторяющихся токенов. Здесь преимущество остается за тяжеловесными облачными системами вроде GPT-6 Astra, которые обладают достаточным объемом параметров для управления сложными лингвистическими ограничениями.
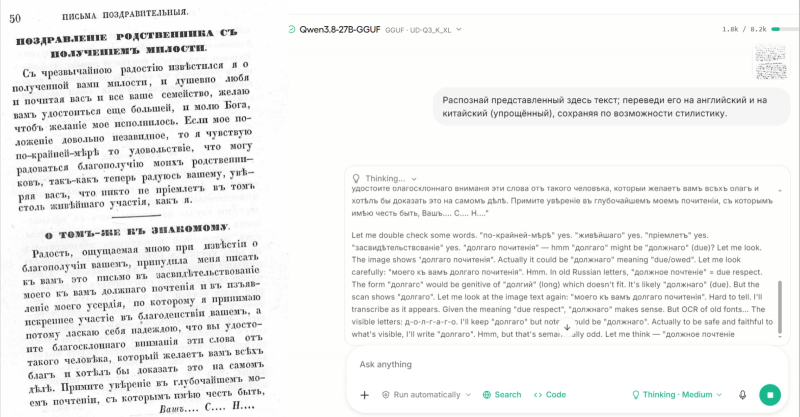
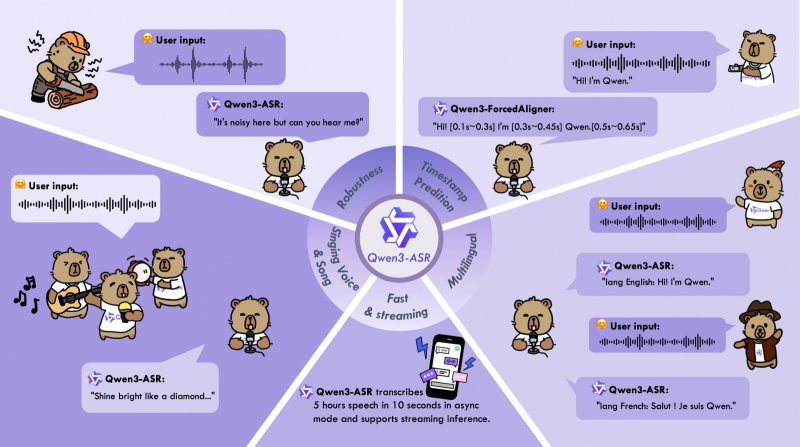
Несмотря на ограничения, мультимодальные возможности Qwen3.8-27B открывают интересные перспективы. Модель способна распознавать тексты с дореволюционной орфографией и переводить их на современные языки, что делает её полезным инструментом для работы с архивами. Также она эффективно справляется с анализом визуальных мемов, разделяя техническую ошибку и комический эффект. Для тех же, кому требуется работа с аудио, существуют специализированные ветки Qwen-Audio (например, Qwen3-ASR), которые позволяют транскрибировать речь локально, обеспечивая полную конфиденциальность разговоров.
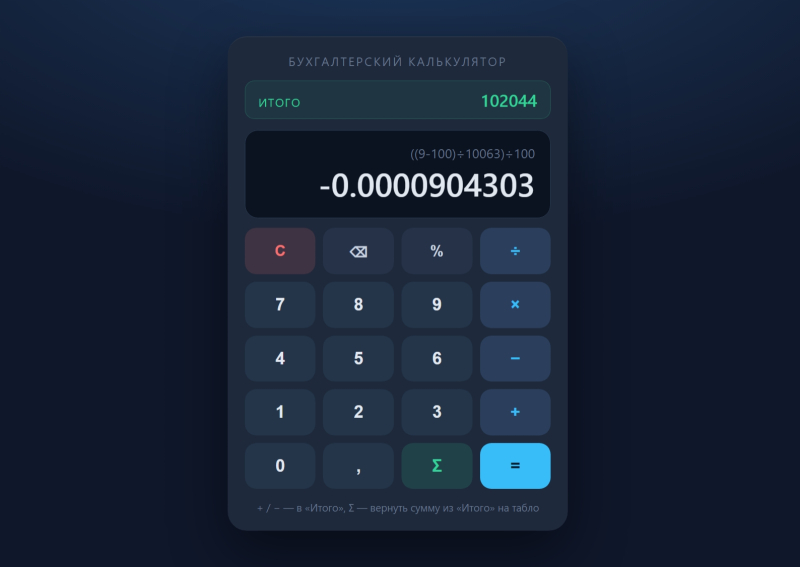
Завершающим испытанием стало написание программного кода. Создание даже простого бухгалтерского калькулятора оказалось серьезным вызовом. Если малая модель 9B часто ошибалась и зависала, то Qwen3.8-27B, несмотря на свою медлительность, смогла создать работоспособный продукт. Процесс занял около шести часов, но результат подтвердил тезис: для сложных инженерных задач глубина рассуждений важнее скорости.
Опыт работы с семейством Qwen показывает, что локальный ИИ перестал быть игрушкой для энтузиастов. Хотя облачные гиганты всё еще лидируют в скорости и поэтике, дистиллированные модели делают высокоуровневый интеллект доступным даже на устаревшем оборудовании. Выбор между скоростью и глубиной рассуждений теперь лежит на пользователе, который сам определяет, где ему важнее эффективность, а где — абсолютная приватность и автономность мышления машины.
 Прогноз кратного роста поставок Nvidia