Глобальная гонка искусственного интеллекта перемещается из плоскости алгоритмов в плоскость аппаратного обеспечения. Тотальная зависимость индустрии от одного поставщика создает критические риски и колоссальное финансовое давление на гиперскейлеров. Meta делает решительный шаг к автономности, разрабатывая собственные ускорители для радикальной оптимизации энергопотребления и затрат. Этот переход знаменует эпоху глубокой вертикальной интеграции, где кремний проектируется под конкретные задачи нейросетей.
Современный рынок ИИ столкнулся с парадоксом: несмотря на стремительный рост возможностей моделей, стоимость их поддержки становится обременительной. Для Meta, оперирующей масштабами миллиардов пользователей, стандартные решения от Nvidia перестают быть оптимальными. Ответ на этот вызов лежит в создании специализированных чипов, которые позволяют выжимать максимум производительности из каждого затраченного ватта и каждого доллага инвестиций.
В центре этой стратегии стоит линейка MTIA (Meta Training and Inference Accelerator). На текущем этапе компания завершает тестирование третьего поколения устройств — MTIA 450, известного под кодовым именем Arke. Параллельно с этим идет работа над следующим этапом: проектирование MTIA 500 (Astrid) завершится в ближайшее время, а полноценное развертывание в дата-центрах ожидается к концу следующего года.
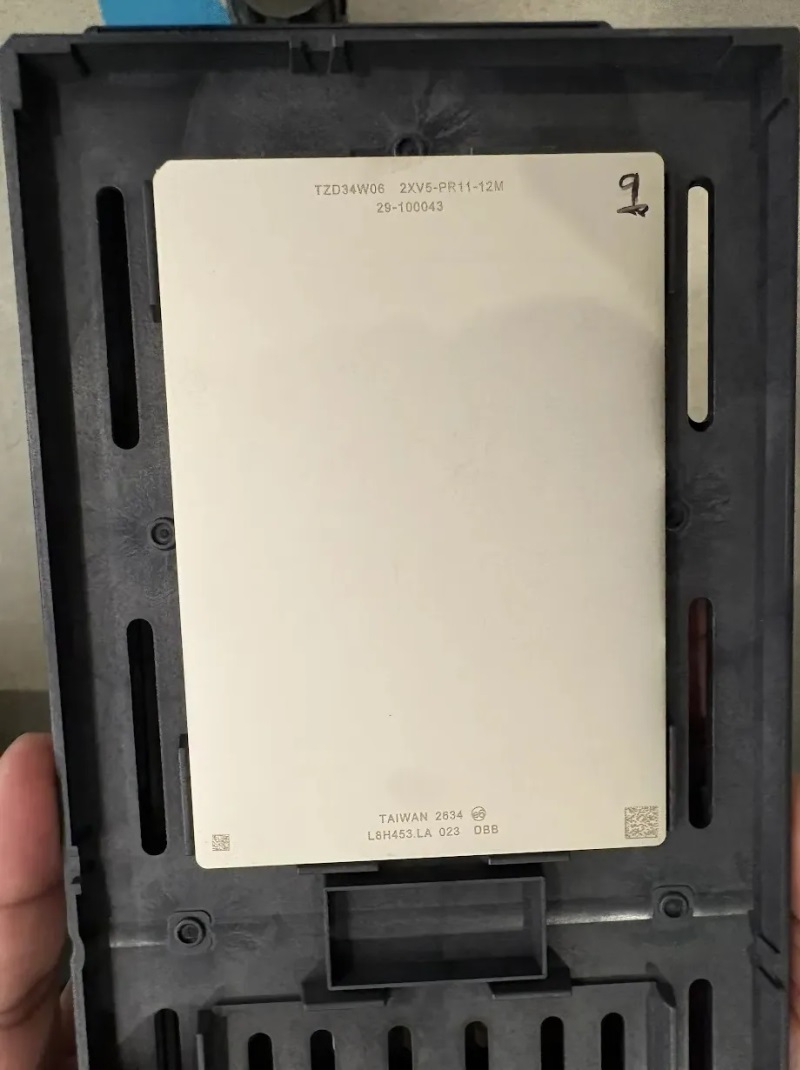
Разработка такого уровня сложности невозможна в изоляции, поэтому Meta выстроила стратегический альянс с ключевыми игроками индустрии. Проектирование чипов осуществляется совместно с Broadcom, а физическое производство доверено TSMC. Такой подход позволяет Meta сосредоточиться на оптимизации рабочих нагрузок, делегируя сложные вопросы литографии и физической реализации проверенным партнерам.
Особую роль в процессе играет подразделение Superintelligence Labs. Инженеры, создающие будущие модели ИИ, работают в тесной связке с разработчиками «железа». Это создает замкнутый цикл обратной связи: требования к будущим нейросетям напрямую определяют спецификации будущих чипов. В результате получается продукт, который по эффективности превосходит универсальные решения Nvidia просто потому, что он изначально «заточен» под конкретные алгоритмы Meta.
Масштабы амбиций подтверждаются и энергетическими показателями. В ближайший год компания намерена задействовать мощности ускорителей суммарной мощностью более одного гигаватта. В индустрии ЦОД это означает переход на совершенно иной уровень плотности вычислений, где даже минимальная оптимизация энергопотребления превращается в экономию миллионов долларов.
Первые результаты эксплуатации подтверждают жизнеспособность концепции. Тестовые образцы, полученные от TSMC, показали поразительную точность: реальная производительность отклонилась от результатов симуляций всего на 2–3%. Более того, устройства успешно справились не только с внутренними моделями Meta, но и с внешними алгоритмами от DeepSeek и Alibaba, что подтверждает универсальность подхода к инференсу.
Интересен и стратегический отказ от проекта Olympus. Изначально планировалось создать универсальный чип, способный одинаково эффективно и обучать модели, и обеспечивать их работу (инференс). Однако экономика гигаваттных масштабов диктует свои правила: стоимость универсального решения оказалась на 30% выше специализированного. В условиях экстремального масштабирования такая разница становится неприемлемой.
В итоге Meta делает ставку на создание «рабочих лошадок» — устройств, оптимизированных для общего инференса с использованием памяти с высокой пропускной способностью (HBM). Эти чипы не претендуют на рекордную скорость реакции в узких сегментах, но они обеспечивают необходимую устойчивость и экономическую эффективность, превращая инфраструктуру ИИ из статьи расходов в высокоэффективный актив.
 Старт продаж экосистемы Googlebook